Tu espacio cultural para descubrir novedades sobre libros, cómics, ciencia y eventos culturales.

SERENDIPIA CULTURAL

[wpdts-custom format="D, j M – H:i"]h

16 de septiembre de 2026
CONTACTO

La inteligencia artificial está creando una nueva era de desconfianza en el mundo de la edición de libros

Actualidad, Libros

La industria editorial siempre funcionó sobre una infraestructura bastante invisible: la confianza. Un autor entrega un manuscrito y garantiza que es suyo, un agente lo representa bajo esa premisa y una editorial adquiere los derechos confiando en que la obra es original y que las declaraciones del autor son verdaderas. Existen cláusulas contractuales, controles y antecedentes de plagios o memorias que resultaron no ser del todo ciertas, pero durante décadas la enorme mayoría de las relaciones entre autores y editoriales se construyeron sobre esa presunción básica. La inteligencia artificial está empezando a romperla.

Como venimos contando en las últimas ediciones de esta newsletter, ya aparecieron varios casos en los que una sospecha sobre el uso de IA terminó afectando la publicación de un libro o incluso haciendo caer contratos millonarios. Pero el problema empieza a ser bastante más amplio que esos episodios particulares. La pregunta ya no es solamente si algunos autores están utilizando ChatGPT, Claude u otras herramientas para escribir libros. La cuestión es qué ocurre con una industria cuando cualquier manuscrito puede empezar a ser sospechoso y, al mismo tiempo, no existe una forma concluyente de demostrar quién —o qué— lo escribió.

El caso de Jerry Falade muestra hasta dónde puede llegar esa incertidumbre. Su novela Call Me, I’ll Hide the Body había generado una subasta entre 14 editores y obtenido un anticipo de US$2,4 millones. En julio, Europa Content, la agencia que lo representaba, comunicó a las editoriales que ya no podía respaldar el proyecto porque no podía verificar que el libro hubiera sido escrito íntegramente por Falade. El autor negó haber utilizado IA y sostuvo que las acusaciones estaban racialmente motivadas.

En marzo había ocurrido algo parecido con Shy Girl, de Mia Ballard. Hachette canceló la publicación estadounidense del libro después de que surgieran acusaciones sobre utilización de inteligencia artificial. Ballard negó haberla utilizado para escribir la novela y afirmó que una persona que había intervenido en la edición del texto sí había empleado estas herramientas.

Y después apareció Daggermouth, de H.M. Wolfe, que siguió un camino completamente diferente. Un estudio todavía no revisado por pares sometió el libro a Pangram y obtuvo una estimación de alrededor de 60% de contenido generado con IA. Simon & Schuster rechazó que pudieran extraerse conclusiones sobre la autoría a partir de ese tipo de detectores, respaldó públicamente a Wolfe, publicó el libro y adquirió más obras de la autora. Daggermouth vendió más de 31.000 ejemplares durante su primera semana y debutó en el número uno de la lista de ficción de tapa dura de The New York Times.

La comparación resulta incómoda porque muestra algo que la industria aún no resolvió: no existe un estándar compartido sobre qué significa exactamente “haber utilizado IA” para escribir un libro, ni sobre qué evidencia sería suficiente para actuar frente a una sospecha. Kathleen Schmidt (una referente en el sector que solemos citar) planteó en su blog esta contradicción utilizando justamente Daggermouth y Shy Girl. Entre las cifras que circularon públicamente, Pangram estimó aproximadamente un 60% para el primero y un 78% para el segundo. No puede concluirse que esos porcentajes hayan sido por sí solos los responsables de las decisiones de las editoriales, pero la comparación deja una pregunta relevante: si dos empresas pueden reaccionar de maneras completamente diferentes ante señales aparentemente similares, ¿qué criterio se está aplicando realmente?

Incluso si mañana existiera un detector capaz de identificar perfectamente qué frases fueron generadas por un modelo, la industria todavía tendría que decidir qué hacer con esa información.

Ese es uno de los motivos por los que los actuales detectores plantean tantos problemas. A diferencia de los sistemas tradicionales antiplagio, que buscan coincidencias entre un texto y una enorme base de contenidos existentes, herramientas como Pangram, GPTZero o el detector de Turnitin intentan inferir la procedencia de un texto a partir de patrones estadísticos: vocabulario, estructura, ritmo, longitud de las frases, repetición, previsibilidad y otras características que pueden aparecer con determinada frecuencia en los modelos generativos. El resultado no es una coincidencia verificable. Es una probabilidad.

El riesgo es evidente: una herramienta probabilística puede terminar interviniendo en decisiones que no son probabilísticas en absoluto. Un contrato se firma o no se firma. Un libro se publica o se cancela. Un agente representa o deja de representar a un autor. Y una acusación pública puede afectar una reputación aunque posteriormente sea imposible demostrar que era correcta.

Carly Watters, agente literaria, publicó recientemente una guía para escritores cuya premisa resulta bastante reveladora: los autores deberían estar preparados para dar pruebas sobre cómo escribieron sus libros. Su recomendación es documentar el workflow completo, desde la aparición de la idea hasta la investigación, la escritura y la edición. Qué herramientas se utilizaron. Dónde se trabajó. En qué momento. Qué versiones existen. Qué software intervino. Eso introduce una transformación bastante profunda: la prueba de autoría empieza a desplazarse desde el texto terminado hacia la trazabilidad del proceso que lo produjo.

Hasta ahora una editorial recibía fundamentalmente un resultado: el manuscrito. En el escenario que comienza a dibujarse, podría necesitar también alguna evidencia sobre su historia. Versiones anteriores. Borradores. Notas. Historiales. Herramientas utilizadas. Declaraciones sobre uso de IA.

Pero la cuestión se vuelve todavía más compleja porque la trazabilidad no termina necesariamente en el autor. Watters recomienda que los escritores sepan también qué ocurre cuando otras personas acceden a su manuscrito. ¿Dónde lo almacena el agente? ¿Qué software utiliza para editarlo? ¿Qué hacen los beta readers? ¿Qué aplicaciones utiliza cada persona que interviene sobre el texto? De seguir esta lógica, podríamos terminar hablando de una especie de cadena de custodia del manuscrito.

La desconfianza está modificando el trabajo cotidiano de agentes y editores. La presencia de los modelos generativos no estaría entonces modificando solamente los textos producidos por máquinas. Podría empezar a modificar también la escritura de quienes no los utilizan.

Durante años discutimos qué iba a cambiar la inteligencia artificial en la escritura y en la edición. Una de las primeras transformaciones importantes podría estar ocurriendo en un lugar menos visible: en la relación de confianza entre quienes participan de la creación de un libro. Hasta ahora, demostrar la autoría significaba esencialmente afirmar “yo escribí esta obra” y asumir contractualmente la responsabilidad por ella. En la era de la inteligencia artificial puede que eso empiece a no alcanzar. Quizás, cada vez más, un autor tenga que estar preparado para responder una segunda pregunta: “¿Puede demostrar cómo la escribió?”
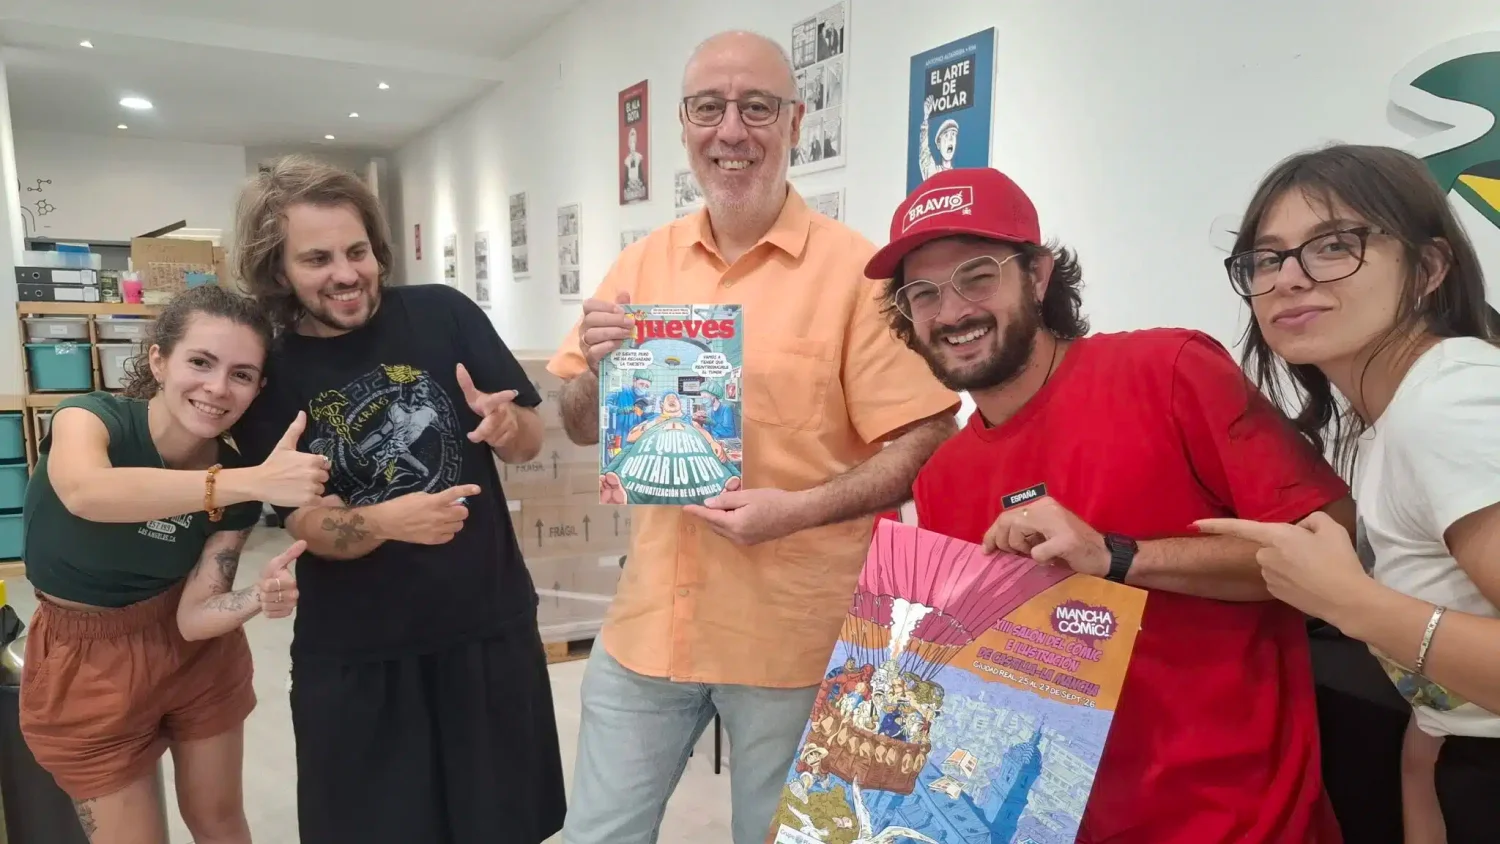
ManchaCómic homenajea en su trece cumpleaños la irreverencia de "El Jueves"

Actualidad, Cómics

No será en la 13 Rue del Percebe, pero sí la trece edición en los Jardines del Prado, el ... Leer más

Amazon (también) escanea y destruye libros físicos para entrenamiento de inteligencias artificiales

Actualidad

Esta semana, salió a luz una investigación elaborada por 404 Media (muy detallada) a partir de un AirTag (un dispositivo de Apple que ... Leer más

Argentina: finalmente se conservará la Ley de Defensa de la Actividad Librera

Actualidad, Libros

El proyecto para derogar la Ley de Defensa de la Actividad Librera finalmente no llegará, por ahora, al Congreso ... Leer más

La inteligencia artificial está creando una nueva era de desconfianza en el mundo de la edición de libros

15 de septiembre de 2026

,

La industria editorial siempre funcionó sobre una infraestructura bastante invisible: la confianza. Un autor entrega un manuscrito y garantiza que es suyo, un agente lo representa bajo esa premisa y una editorial adquiere los derechos confiando en que la obra es original y que las declaraciones del autor son verdaderas. Existen cláusulas contractuales, controles y antecedentes de plagios o memorias que resultaron no ser del todo ciertas, pero durante décadas la enorme mayoría de las relaciones entre autores y editoriales se construyeron sobre esa presunción básica. La inteligencia artificial está empezando a romperla.

Como venimos contando en las últimas ediciones de esta newsletter, ya aparecieron varios casos en los que una sospecha sobre el uso de IA terminó afectando la publicación de un libro o incluso haciendo caer contratos millonarios. Pero el problema empieza a ser bastante más amplio que esos episodios particulares. La pregunta ya no es solamente si algunos autores están utilizando ChatGPT, Claude u otras herramientas para escribir libros. La cuestión es qué ocurre con una industria cuando cualquier manuscrito puede empezar a ser sospechoso y, al mismo tiempo, no existe una forma concluyente de demostrar quién —o qué— lo escribió.

El caso de Jerry Falade muestra hasta dónde puede llegar esa incertidumbre. Su novela Call Me, I’ll Hide the Body había generado una subasta entre 14 editores y obtenido un anticipo de US$2,4 millones. En julio, Europa Content, la agencia que lo representaba, comunicó a las editoriales que ya no podía respaldar el proyecto porque no podía verificar que el libro hubiera sido escrito íntegramente por Falade. El autor negó haber utilizado IA y sostuvo que las acusaciones estaban racialmente motivadas.

En marzo había ocurrido algo parecido con Shy Girl, de Mia Ballard. Hachette canceló la publicación estadounidense del libro después de que surgieran acusaciones sobre utilización de inteligencia artificial. Ballard negó haberla utilizado para escribir la novela y afirmó que una persona que había intervenido en la edición del texto sí había empleado estas herramientas.

Y después apareció Daggermouth, de H.M. Wolfe, que siguió un camino completamente diferente. Un estudio todavía no revisado por pares sometió el libro a Pangram y obtuvo una estimación de alrededor de 60% de contenido generado con IA. Simon & Schuster rechazó que pudieran extraerse conclusiones sobre la autoría a partir de ese tipo de detectores, respaldó públicamente a Wolfe, publicó el libro y adquirió más obras de la autora. Daggermouth vendió más de 31.000 ejemplares durante su primera semana y debutó en el número uno de la lista de ficción de tapa dura de The New York Times.

La comparación resulta incómoda porque muestra algo que la industria aún no resolvió: no existe un estándar compartido sobre qué significa exactamente “haber utilizado IA” para escribir un libro, ni sobre qué evidencia sería suficiente para actuar frente a una sospecha. Kathleen Schmidt (una referente en el sector que solemos citar) planteó en su blog esta contradicción utilizando justamente Daggermouth y Shy Girl. Entre las cifras que circularon públicamente, Pangram estimó aproximadamente un 60% para el primero y un 78% para el segundo. No puede concluirse que esos porcentajes hayan sido por sí solos los responsables de las decisiones de las editoriales, pero la comparación deja una pregunta relevante: si dos empresas pueden reaccionar de maneras completamente diferentes ante señales aparentemente similares, ¿qué criterio se está aplicando realmente?

Incluso si mañana existiera un detector capaz de identificar perfectamente qué frases fueron generadas por un modelo, la industria todavía tendría que decidir qué hacer con esa información.

Ese es uno de los motivos por los que los actuales detectores plantean tantos problemas. A diferencia de los sistemas tradicionales antiplagio, que buscan coincidencias entre un texto y una enorme base de contenidos existentes, herramientas como Pangram, GPTZero o el detector de Turnitin intentan inferir la procedencia de un texto a partir de patrones estadísticos: vocabulario, estructura, ritmo, longitud de las frases, repetición, previsibilidad y otras características que pueden aparecer con determinada frecuencia en los modelos generativos. El resultado no es una coincidencia verificable. Es una probabilidad.

El riesgo es evidente: una herramienta probabilística puede terminar interviniendo en decisiones que no son probabilísticas en absoluto. Un contrato se firma o no se firma. Un libro se publica o se cancela. Un agente representa o deja de representar a un autor. Y una acusación pública puede afectar una reputación aunque posteriormente sea imposible demostrar que era correcta.

Carly Watters, agente literaria, publicó recientemente una guía para escritores cuya premisa resulta bastante reveladora: los autores deberían estar preparados para dar pruebas sobre cómo escribieron sus libros. Su recomendación es documentar el workflow completo, desde la aparición de la idea hasta la investigación, la escritura y la edición. Qué herramientas se utilizaron. Dónde se trabajó. En qué momento. Qué versiones existen. Qué software intervino. Eso introduce una transformación bastante profunda: la prueba de autoría empieza a desplazarse desde el texto terminado hacia la trazabilidad del proceso que lo produjo.

Hasta ahora una editorial recibía fundamentalmente un resultado: el manuscrito. En el escenario que comienza a dibujarse, podría necesitar también alguna evidencia sobre su historia. Versiones anteriores. Borradores. Notas. Historiales. Herramientas utilizadas. Declaraciones sobre uso de IA.

Pero la cuestión se vuelve todavía más compleja porque la trazabilidad no termina necesariamente en el autor. Watters recomienda que los escritores sepan también qué ocurre cuando otras personas acceden a su manuscrito. ¿Dónde lo almacena el agente? ¿Qué software utiliza para editarlo? ¿Qué hacen los beta readers? ¿Qué aplicaciones utiliza cada persona que interviene sobre el texto? De seguir esta lógica, podríamos terminar hablando de una especie de cadena de custodia del manuscrito.

La desconfianza está modificando el trabajo cotidiano de agentes y editores. La presencia de los modelos generativos no estaría entonces modificando solamente los textos producidos por máquinas. Podría empezar a modificar también la escritura de quienes no los utilizan.

Durante años discutimos qué iba a cambiar la inteligencia artificial en la escritura y en la edición. Una de las primeras transformaciones importantes podría estar ocurriendo en un lugar menos visible: en la relación de confianza entre quienes participan de la creación de un libro. Hasta ahora, demostrar la autoría significaba esencialmente afirmar “yo escribí esta obra” y asumir contractualmente la responsabilidad por ella. En la era de la inteligencia artificial puede que eso empiece a no alcanzar. Quizás, cada vez más, un autor tenga que estar preparado para responder una segunda pregunta: “¿Puede demostrar cómo la escribió?”
Otras noticias que te puede interesar

Ver más noticias

ManchaCómic homenajea en su trece cumpleaños la irreverencia de "El Jueves"

ManchaCómic homenajea en su trece cumpleaños la irreverencia de "El Jueves"

12 de septiembre de 2026

,

No será en la 13 Rue del Percebe, pero sí la trece edición en los Jardines del Prado, el antiguo Casino y ... Leer más

Amazon (también) escanea y destruye libros físicos para entrenamiento de inteligencias artificiales

Amazon (también) escanea y destruye libros físicos para entrenamiento de inteligencias artificiales

7 de septiembre de 2026

Esta semana, salió a luz una investigación elaborada por 404 Media (muy detallada) a partir de un AirTag (un dispositivo de Apple que permite rastrear objetos ... Leer más

Argentina: finalmente se conservará la Ley de Defensa de la Actividad Librera

Argentina: finalmente se conservará la Ley de Defensa de la Actividad Librera

7 de septiembre de 2026

,

El proyecto para derogar la Ley de Defensa de la Actividad Librera finalmente no llegará, por ahora, al Congreso argentino. Patricia Bullrich, ... Leer más

COLABORAN

Resumen de privacidad

Esta web utiliza cookies para que podamos ofrecerte la mejor experiencia de usuario posible. La información de las cookies se almacena en tu navegador y realiza funciones tales como reconocerte cuando vuelves a nuestra web o ayudar a nuestro equipo a comprender qué secciones de la web encuentras más interesantes y útiles.
Mas información en política de privacidad y cookies.

Cookies estrictamente necesarias

Las cookies estrictamente necesarias tiene que activarse siempre para que podamos guardar tus preferencias de ajustes de cookies.

Cookies de terceros

Esta web utiliza Google Analytics para recopilar información anónima tal como el número de visitantes del sitio, o las páginas más populares.

Son aquéllas que posibilitan el seguimiento y análisis del comportamiento de los usuarios en nuestra página. La información recogida se utiliza para la medición de la actividad de los usuarios en la web y la elaboración de perfiles de navegación de los usuarios, con la finalidad de mejorar la web, así como los productos y servicios ofertados.

Dejar esta cookie activa nos permite mejorar nuestra web.

Cookies de personalización

Estas cookies pueden ser establecidas a través de nuestro sitio por nuestros socios publicitarios. Pueden ser utilizadas por esas empresas para crear un perfil de sus intereses y mostrarle anuncios relevantes en otros sitios. No almacenan directamente información personal, sino que se basan en la identificación única de su navegador y dispositivo de Internet. Si no permite utilizar estas cookies, verá menos publicidad dirigida.